摘要
本实验测试 JEV 能否复现 LLM 裁判在两条思考之间的偏好。场景是 150 道开放式推理题,每题配一个偏好对:裁判的优胜思考与同题随机一条落选思考,由 JEV 二选一。JEV 与裁判的一致率为 83.3%(95% 置信区间 76.6%–88.4%),远高于 50% 的随机水平,它也不偏向某一侧:优胜思考在 A、B 两侧时一致率接近(82.9%、83.8%)。confidence 能区分可采信的判断与低可靠度的判断:不低于 0.8 的 24 对零错误,低于 0.2 的 24 对一致率明显下降(54.2%)。另一布局把候选文本放入 criteria,一致率降至 79.3%。标准布局消耗输入 359,825 token、输出 4,650 token,总费用 0.0151 美元。结论是:给这批偏好对做标注,二选一这个形态可以直接交给 JEV,confidence 可作为筛选依据。
1 实验目的
本实验测 JEV 的成对判优能力:在同一题目的两条思考中选出质量更好的一条。这个场景来自 DPO 类训练:训练需要偏好对,每对要定出 chosen 与 rejected,标注要做的正是这样的二选一。每对的优胜思考由 DeepSeek LLM 裁判选定,本实验检验 JEV 能否复现裁判的偏好。
与 grpo-jev-judge 的关系
本实验的偏好对取自 grpo-jev-judge 的上游数据:同样的 150 道题、每题同样的八条 rollout、同样的裁判优胜思考(见 experiments/grpo-jev-judge/report/REPORT.md)。每对由裁判优胜思考与同题随机一条落选思考组成。两个实验测同一种判优能力的两种形态:成对二选一(本实验)与组内八选一(后者命中率 45.3%)。
2 数据集
数据集包含 150 个偏好对,每道中文开放式推理题一个。每对的两条思考来自该题的八条 Qwen3-0.6B rollout:chosen 侧是 DeepSeek 裁判选出的优胜思考,rejected 侧是其余七条中的随机一条。优胜思考放在 A 还是 B 由逐对随机决定,最终 76 对的优胜思考在 A、74 对在 B。优胜思考所在的选项即参考答案;JEV 按与裁判相同的质量标准作答。
题目按形式分三类:现象解释、原因排查、权衡建议,各 50 道。这一划分由本次分析依据 id 前缀(g-causal、g-diagnosis、g-tradeoff)划定,不是样本的原始标签。
每个偏好对以两种布局呈现。标准布局把两条思考放在 state.responses,criteria 只放指向它们的指针;criteria-text 布局把思考文本直接作为 criteria,state 只留题目。
3 最小示例
本节取同一道题目,分别展示两种布局下的输入与输出,便于对照。标准布局的输入如下(省略 model 字段):
{
  "state": {
    "prompt": "一位同事离职前留下一份交接文档,接手的职员照着文档操作却还是经常出错。请你解释为什么有文档交接仍然会出错。",
    "responses": {
      "A": "嗯,用户的问题是说一个同事离职后留了文档,接手的同事照着操作却还是经常出错,现在需要解释为什么即使有交接文档也会出错。首先,我需要理解用户的问题核心。他们想知道为什么即使有交接文档,接手者还是会出现错误,可能的原因有哪些。……",
      "B": "嗯,让我来想想这个情况。职员离职后,根据交接文档操作,却还是经常出错。那为什么会这样呢?首先,交接文档可能内容不够详细或者不够准确,或者有遗漏的信息。……"
    }
  },
  "questions": {
    "better": {
      "type": "choice",
      "instructions": "一、任务\n从 responses.A 与 responses.B 中选出思维质量更好的一条。\n……(其余六节省略)",
      "criteria": {"A": "responses.A", "B": "responses.B"}
    }
  }
}
模型输出如下(仅保留关键字段):
{
  "answers": {
    "better": {
      "type": "choice",
      "choice": "A",
      "probabilities": {"A": 0.74, "B": 0.26},
      "confidence": 0.48
    }
  },
  "usage": {"input_tokens": 2177, "output_tokens": 31, "cost": 0.0000914}
}
JEV 选择了 A,即 LLM 裁判偏好的那条。
criteria-text 布局下,state 只保留题目,两条思考的文本直接作为 criteria,instructions 不变:
{
  "state": {
    "prompt": "一位同事离职前留下一份交接文档,接手的职员照着文档操作却还是经常出错。请你解释为什么有文档交接仍然会出错。"
  },
  "questions": {
    "better": {
      "type": "choice",
      "instructions": "一、任务\n从 responses.A 与 responses.B 中选出思维质量更好的一条。\n……(其余六节省略)",
      "criteria": {
        "A": "嗯,用户的问题是说一个同事离职后留了文档,接手的同事照着操作却还是经常出错,现在需要解释为什么即使有交接文档也会出错。……",
        "B": "嗯,让我来想想这个情况。职员离职后,根据交接文档操作,却还是经常出错。……"
      }
    }
  }
}
模型输出如下(仅保留关键字段):
{
  "answers": {
    "better": {
      "type": "choice",
      "choice": "A",
      "probabilities": {"A": 0.7, "B": 0.3},
      "confidence": 0.39
    }
  },
  "usage": {"input_tokens": 2153, "output_tokens": 31, "cost": 0.0000904}
}
JEV 同样选择了 A,但 confidence 从标准布局的 0.48 降至 0.39。
4 结果
整体结果
150 对均获得有效作答,无失败记录。判据是 DeepSeek LLM 裁判的偏好:题目是开放式问题,没有标准答案,因此测的是与裁判的一致性,而非正确性。JEV 与裁判一致 125 对,一致率 83.3%,95% 置信区间 76.6%–88.4%;二选一随机作答的一致率为 50%。
按题型分组
三类题型的一致率基本持平:
| 题型 | 对数 | 一致 | 一致率 |
|---|---|---|---|
| 现象解释 | 50 | 42 | 84.0% |
| 原因排查 | 50 | 41 | 82.0% |
| 权衡建议 | 50 | 42 | 84.0% |
置信关系
JEV 对每对报告一个 confidence。一致率随 confidence 单调上升,最低档接近随机,最高档零错误(图 1):
| Confidence | 对数 | 占比 | 一致率 |
|---|---|---|---|
| < 0.2 | 24 | 16.0% | 54.2% |
| 0.2–0.4 | 31 | 20.7% | 71.0% |
| 0.4–0.6 | 24 | 16.0% | 87.5% |
| 0.6–0.8 | 47 | 31.3% | 95.7% |
| ≥ 0.8 | 24 | 16.0% | 100% |
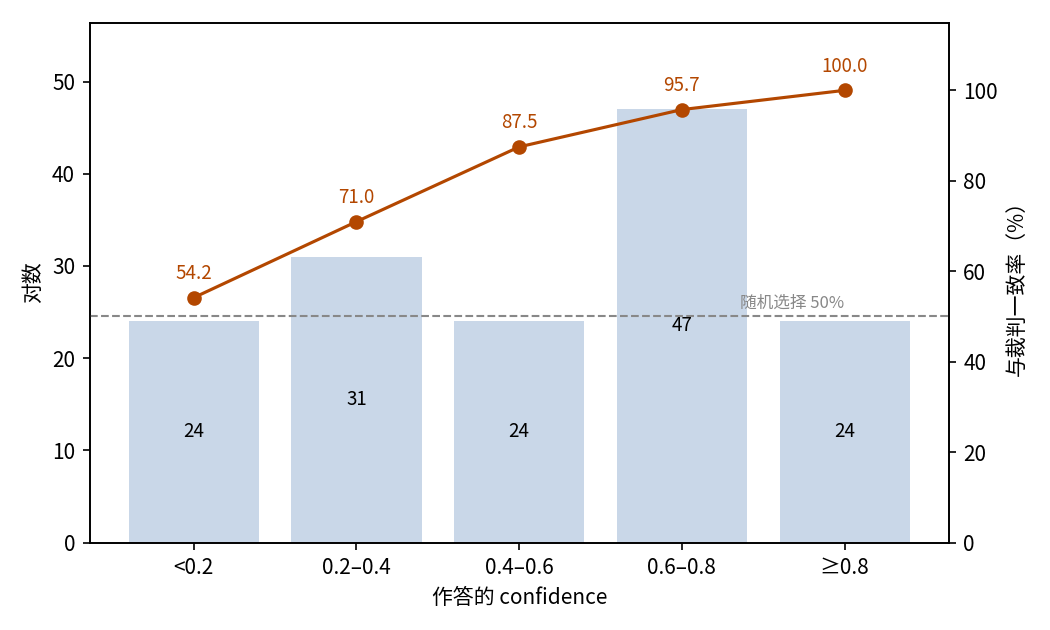
图 1:一致率随 confidence 单调上升;最高档零错误,最低档接近虚线标出的 50% 随机水平。
两组差距明显:与裁判一致时 confidence 均值 0.559,不一致时 0.257。以 0.8 为阈值可保留 24 对(16.0%)且零错误。
行为统计
JEV 选 A 与选 B 恰好各 75 次;优胜思考在 A 时一致率 82.9%,在 B 时 83.8%,两侧基本一致。全部作答的概率合计均为 1,所选项也都是概率最高的一项。
调用成本
标准布局共消耗输入 359,825 token、输出 4,650 token,总费用 0.0151 美元。
布局消融
两种布局的差别在于候选文本的存放位置。把文本放入 criteria 后,一致率低约四个百分点(两个区间重叠),JEV 更倾向选 A(60.7% 对 50.0%),confidence 整体被压低,按 0.8 阈值可筛出的作答从 24 对降到 1 对;把阈值降到 0.4,仍能筛出 64 对且全部一致:
| 布局 | 一致率(95% 置信区间) | 选 A 次数 | confidence 中位数 | 输入 token | 输出 token | 费用 |
|---|---|---|---|---|---|---|
| 标准布局 | 83.3%(76.6%–88.4%) | 75(50.0%) | 0.55 | 359,825 | 4,650 | 0.0151 美元 |
| criteria-text | 79.3%(72.2%–85.0%) | 91(60.7%) | 0.32 | 356,225 | 4,650 | 0.0150 美元 |
criteria-text 布局下 JEV 有 60.7% 的作答选 A;优胜思考在 A 时一致率 89.5%,在 B 时降至 68.9%。confidence 同样被压低:不低于 0.8 的只有 1 对,标准布局有 24 对;把阈值降到 0.4,criteria-text 仍有 64 对且全部一致。
5 结论
成对形态下,JEV 每六对中约五对能复现 LLM 裁判的偏好,优胜思考在 A、B 两侧时一致率接近,未见对某一侧的偏袒。confidence 高的判断极少出错,低的判断可靠度明显下降。给这批偏好对做标注可直接采用二选一,再按 confidence 筛选,把低 confidence 的部分转人工复核。标准布局下选择更均衡、confidence 更高,本实验因此以标准布局为准。
相关资料
- DPO 论文:https://arxiv.org/abs/2305.18290
- Qwen3-0.6B(rollout 模型):https://huggingface.co/Qwen/Qwen3-0.6B
- DeepSeek API 文档(LLM 裁判):https://api-docs.deepseek.com/